LangGraph só pro handoff: um chatbot em que um modelo de decisão escolhe quem atende
Quase todo tutorial de multiagente começa igual: um LLM gerativo no topo, com um prompt do tipo “classifique a intenção do usuário e responda em JSON”. Funciona. Mas cada mensagem do cliente vira uma chamada de LLM inteira só pra decidir quem vai responder. Você recebe um rótulo, não uma confiança. E de vez em quando o JSON volta quebrado.
Eu queria ver como fica essa arquitetura com outra peça no lugar do roteador: um modelo de decisão. É um modelo que não gera texto. Você manda um estado e uma pergunta com opções fixas, e ele devolve uma probabilidade por opção. Com isso dá pra fazer uma coisa simples que com LLM fica improvisada: se a confiança está baixa, o bot pergunta antes de agir.
Montei uma POC de chatbot de pós-venda pra uma loja fictícia, em Python, com LangChain e LangGraph. Gastei US$0,07 de API no total. Neste post eu mostro a arquitetura, o código que importa, como troquei de provedor mudando uma flag e, principalmente, onde a coisa falhou.
O código está em github.com/gabrielcaiana/poc-langchain-roteamento-decisao.
Sumário
- A conclusão primeiro
- Nada de fluxo engessado
- A arquitetura em uma imagem
- Um turno, do começo ao fim
- Como é uma chamada ao modelo de decisão
- Um contrato, vários provedores
- A política de roteamento cabe em quatro linhas
- Subagentes que conversam de verdade
- O que eu vi rodando
- Os números, com o tamanho certo
- Onde quebrou
- Quanto custou e como eu travei o gasto
- Limitações
- Como rodar
- O próximo passo
A conclusão primeiro
- O roteador foi a parte fácil. Nos 76 turnos de avaliação, os três provedores (MSD1, Jev e um classificador LLM) acertaram 100% dos casos não ambíguos.
- O valor do modelo de decisão não é “acertar mais”. É contrato fixo, custo e latência menores e uma probabilidade que dá pra usar como threshold. O MSD1 custou US$0,0007 nos 76 turnos, contra US$0,022 do classificador LLM, com mediana de 232 ms contra 897 ms.
- 76 turnos é uma amostra pequena. A diferença de 98,7% contra 96,1% são dois turnos. Não dá pra dizer qual provedor é melhor.
- O difícil está no subagente. O agente de clarificação às vezes respondeu em vez de perguntar, e o financeiro abriu chamado de cobrança duplicada num pedido em que a base registra uma cobrança só.
Nada de fluxo engessado
Uma decisão eu tomei antes de escrever a primeira linha: o bot não tem menu, formulário nem uma sequência fixa de etapas. O cliente escreve do jeito que quiser.
Cada subagente é um agente de verdade (LLM com tools) que decide sozinho o que perguntar e quando agir. A cada mensagem, a camada de decisão responde uma pergunta só: quem atende agora?
Com isso, trocar de assunto no meio da conversa, mandar um follow-up curto (“e quanto tempo demora?”) ou falar algo vago (“não tô satisfeito”) são coisas que o próprio desenho resolve, sem um caso especial pra cada uma.
São cinco subagentes:
| Subagente | Tools |
|---|---|
| devolução | buscar_pedido, consultar_politica, abrir_solicitacao_devolucao |
| suporte | buscar_pedido, atualizar_endereco |
| financeiro | buscar_pedido, consultar_politica, abrir_chamado_financeiro |
| clarificação | nenhuma |
| fora de escopo | nenhuma |
Os pedidos, a política da loja e as tools são simulados. Nada ali é dado de cliente real.
A arquitetura em uma imagem
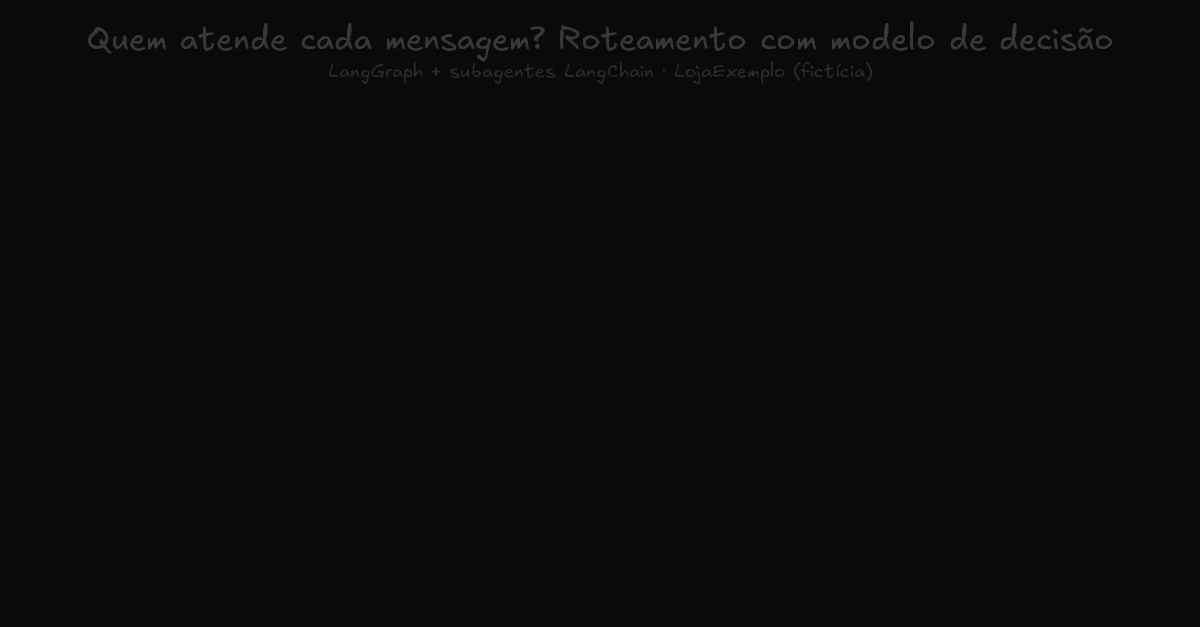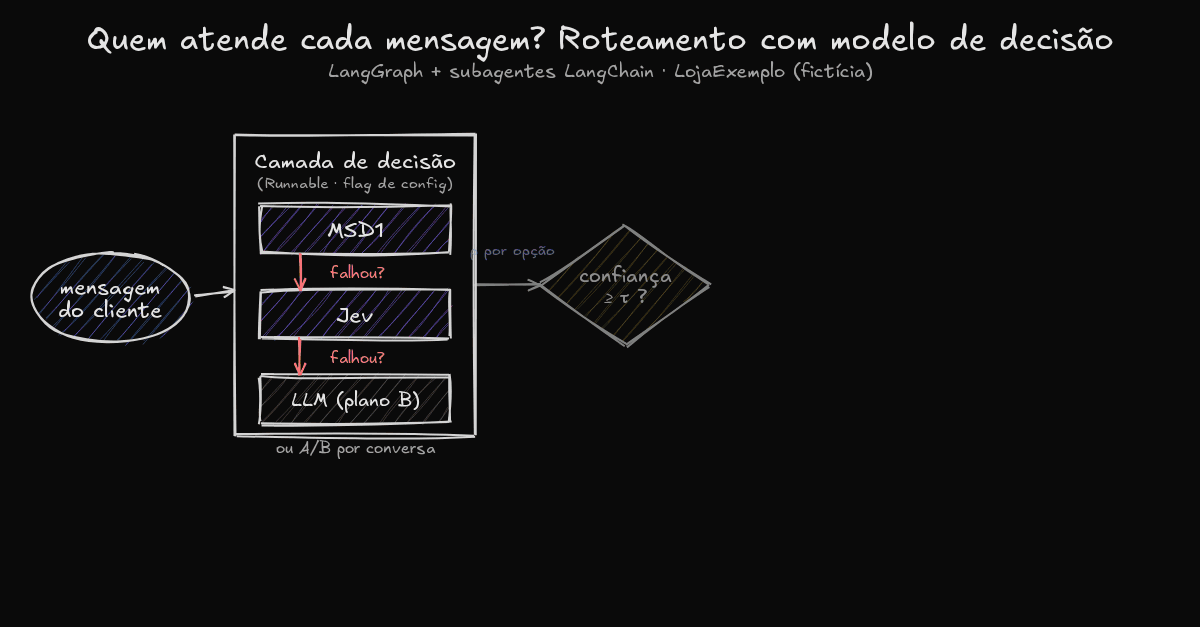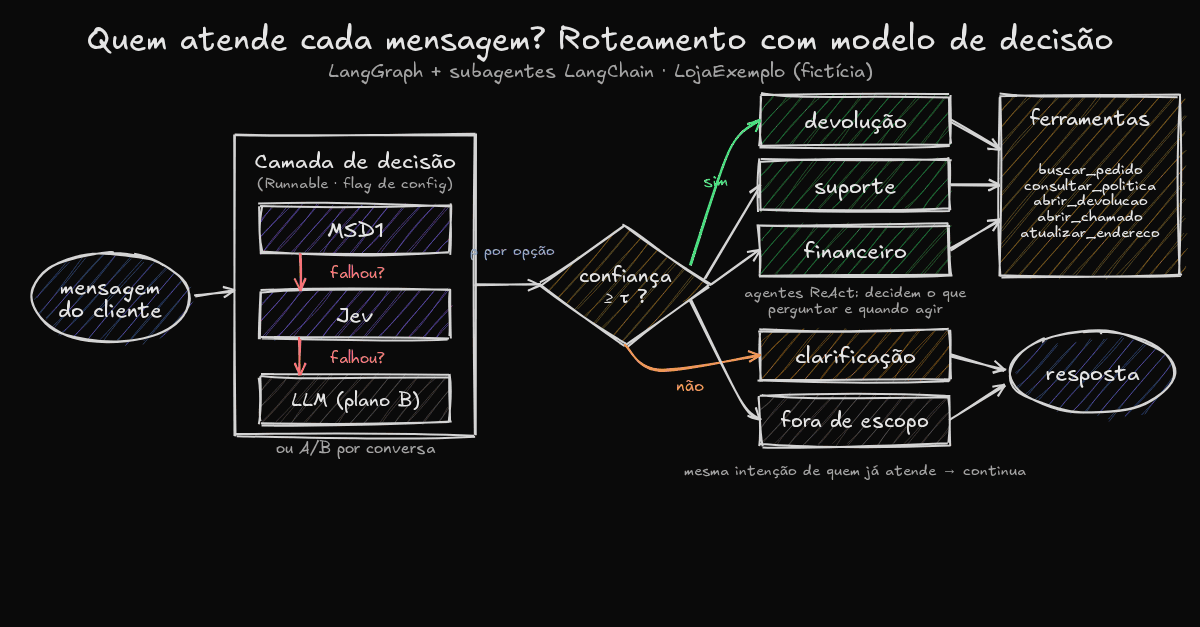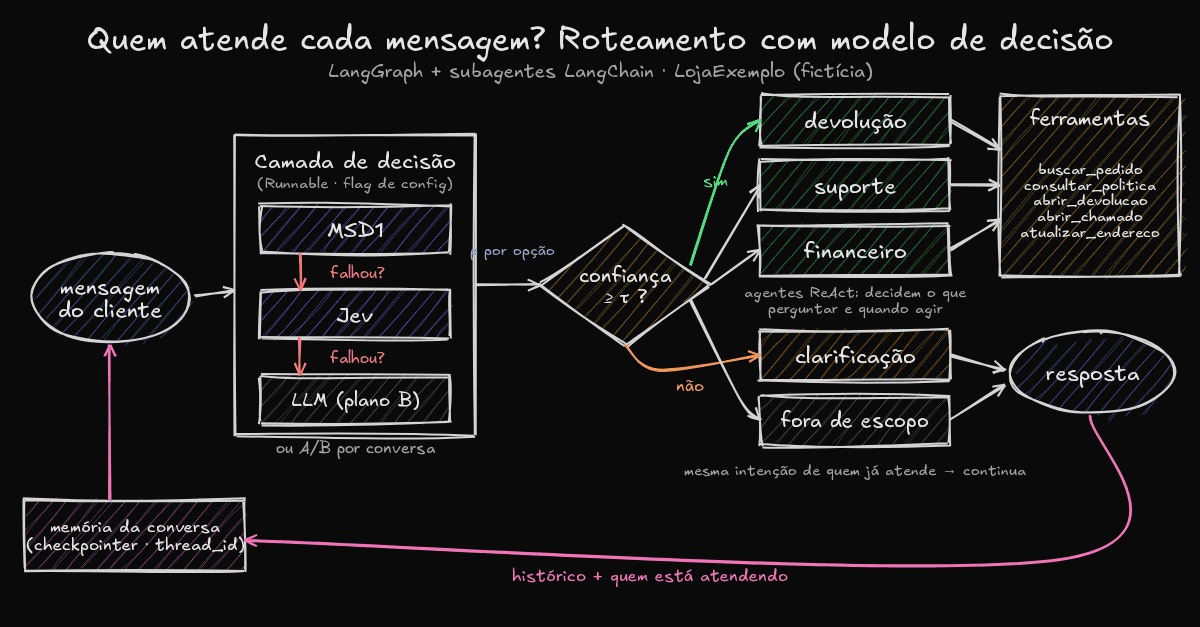
A mensagem passa pela camada de decisão, o threshold escolhe o subagente e a memória volta pro próximo turno.
O LangGraph aqui faz só a orquestração do handoff. O grafo tem um nó classificar e um nó por subagente, e cada subagente termina em END. O grafo não modela as etapas do atendimento. A “etapa” em que a conversa está fica no histórico de mensagens, e quem cuida dela é o subagente.
Por que LangGraph, então, se ele faz tão pouco? Porque ele me deu de graça o que um chatbot multi-turno precisa e que eu não queria reescrever:
- estado tipado com reducers (
add_messagespra acumular a conversa); - checkpointer por
thread_id, que é a memória da conversa; - arestas condicionais pro handoff.
Do LangChain, eu usei as peças padronizadas: o classificador é um Runnable (aparece nos traces e aceita callbacks), as tools são @tool e os subagentes saem do create_react_agent. O LLM gerativo é o Gemini 3.5 Flash Lite, chamado via ChatOpenAI apontado pro OpenRouter.
O estado do grafo é pequeno:
class Estado(TypedDict, total=False):
    messages: Annotated[list[BaseMessage], add_messages]   # memória da conversa
    agente_atual: str | None                               # quem atendeu o último turno
    decisao: dict                                          # decisão do turno corrente
    trilha: Annotated[list[dict], operator.add]            # log de roteamento de todos os turnos
E a montagem também:
g = StateGraph(Estado)
g.add_node("classificar", classificar)
for nome in PROMPTS:
    g.add_node(nome, no_agente(nome))
    g.add_edge(nome, END)
g.add_edge(START, "classificar")
g.add_conditional_edges("classificar", lambda s: s["decisao"]["destino"], {n: n for n in PROMPTS})
return g.compile(checkpointer=checkpointer or MemorySaver())
Um turno, do começo ao fim
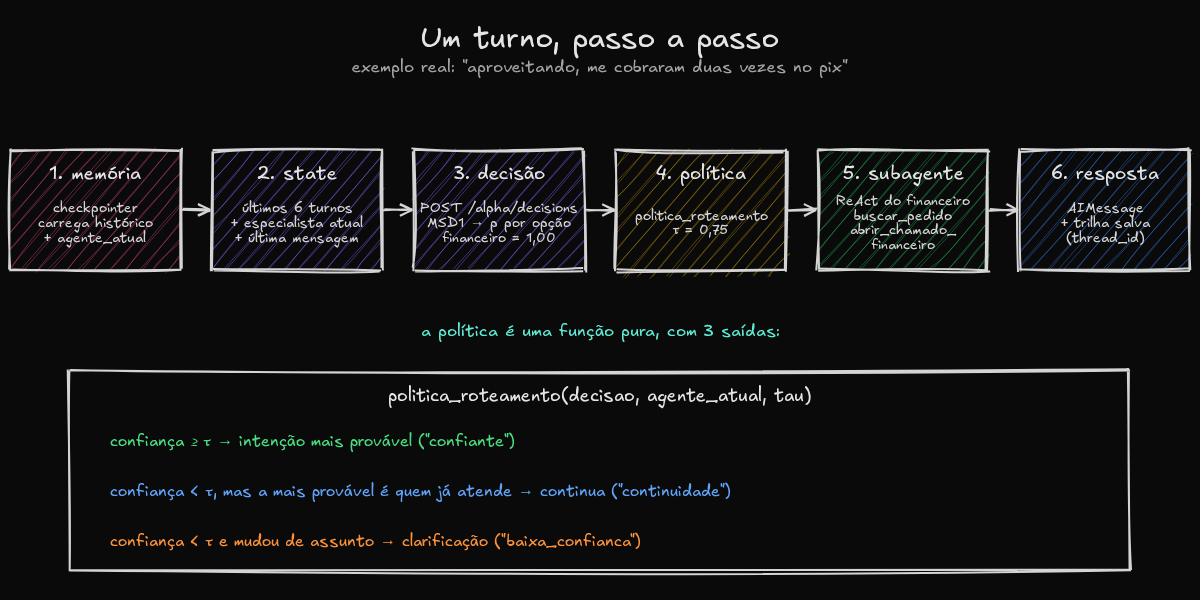
Um turno real: "aproveitando, me cobraram duas vezes no pix".
Pegando uma mensagem real da demo, no meio de uma conversa sobre entrega:
- O checkpointer carrega o histórico e quem está atendendo (
suporte). - O
ClassificadorIntencaomonta o state: os últimos 6 turnos compactos, o especialista atual e a última mensagem do cliente. - O modelo de decisão devolve
financeiro=1.00. - A política aplica o threshold de 0,75 e manda pro financeiro.
- O financeiro chama
buscar_pedido,consultar_politicaeabrir_chamado_financeiro. - A resposta volta como
AIMessage(name="financeiro"), e a decisão vai pratrilha.
Mandar o histórico pro modelo de decisão é o que faz esse desenho funcionar. Sem ele, “pode abrir sim” ou “tem protocolo?” não têm intenção nenhuma. No conjunto de avaliação, os 12 follow-ups que dependem do histórico foram roteados certo pelos três provedores.
Como é uma chamada ao modelo de decisão
O modelo principal é o Microsoft-Decision-1 (MSD1), chamado pelo endpoint de decisões do OpenRouter, que ainda está em alpha. A pergunta é do tipo choice, com um critério em texto por opção:
PERGUNTA = {"type": "choice",
            "instructions": ("Num atendimento de pós-venda, qual especialista deve responder à ÚLTIMA mensagem do cliente? "
                             "Use o histórico para entender mensagens curtas de continuação (ex.: 'e quanto tempo demora?')."),
            "criteria": INTENCOES}  # devolucao, suporte, financeiro, fora_de_escopo, cada um com uma descrição
O corpo do POST https://openrouter.ai/api/alpha/decisions é só {model, state, questions}. O state, montado pelo classificador:
{
  "especialista_atual": "nenhum",
  "historico": [],
  "ultima_mensagem_cliente": "não tô satisfeito"
}
E o que voltou, tirado do trace da demo:
{
  "answers": {"intencao": {"probabilities": {
    "devolucao": 0.677255, "fora_de_escopo": 0.319913,
    "suporte": 0.001679, "financeiro": 0.001154}}},
  "usage": {"input_tokens": 201, "output_tokens": 1, "cost": 8.442e-06}
}
A confiança foi 0,68, abaixo do threshold de 0,75, então o turno foi pra clarificação. Essa chamada custou menos de um milésimo de centavo de dólar e levou 268 ms.
Um contrato, vários provedores
Eu não queria o resto do sistema amarrado ao MSD1. Todo provedor implementa um método só, decidir(estado, pergunta) -> Decisao. O MSD1 e o Jev (typesafe/jev-1.13, da TypeSafe) usam o mesmo endpoint, o mesmo corpo e o mesmo formato de resposta, então são a mesma classe com model diferente:
class ProvedorOpenRouterDecisao:
    def decidir(self, estado, pergunta):
        self.ledger.reservar(...)                                  # trava de orçamento ANTES da chamada
        estado = {k: v for k, v in estado.items() if k != "conversa_id"}
        r = self.transporte({"model": self.modelo, "state": estado, "questions": {"intencao": pergunta}})
        self.ledger.registrar(self.modelo, r["usage"]["cost"])
        probs = r["answers"]["intencao"]["probabilities"]
        ...
O transporte é injetável. É assim que os 13 testes rodam offline e que a demo simula uma queda do MSD1.
Em cima desse contrato, eu montei três coisas:
- Classificador LLM (plano B). O Gemini 3.5 Flash Lite com saída estruturada por JSON schema, devolvendo uma nota de 0 a 1 por intenção. Eu normalizo pra somar 1, mas isso não é uma probabilidade calibrada: é o número que o próprio LLM inventa.
- Fallback.
ProvedorComFallback(primário, secundário)cai pro próximo em qualquer erro, menos estouro de orçamento, que precisa parar tudo. A cadeiamsd1+fallbackémsd1 → jev → llm. - A/B.
ProvedorABescolhe o braço pelo hash dothread_id, então a conversa inteira fica no mesmo provedor. Trocar de provedor no meio da conversa sujaria a comparação.
A escolha fica numa flag:
"decisao": { "provedor": "msd1", "modelos": {"msd1": "microsoft/microsoft-decision-1", "jev": "typesafe/jev-1.13"}, "tau": 0.75 }
Os valores válidos são msd1, jev, llm, msd1+fallback e ab.
Testei o fallback de verdade: simulei um HTTP 503 no MSD1, e os três turnos da conversa foram atendidos pelo Jev, com o motivo registrado no trace (fallback_motivo: RuntimeError: HTTP 503 ... (queda simulada)).
A política de roteamento cabe em quatro linhas
Toda a regra de handoff é uma função pura, coberta por teste:
def politica_roteamento(decisao, agente_atual, tau):
    if decisao.confianca >= tau:
        return decisao.intencao, "confiante"
    if agente_atual and decisao.intencao == agente_atual:
        return agente_atual, "continuidade"
    return "clarificacao", "baixa_confianca"
A segunda regra é a de continuidade. Se a confiança está baixa, mas a intenção mais provável é a de quem já está atendendo, a conversa continua com ele. Isso evita aquelas clarificações chatas no meio de um assunto. E não prende a conversa: se o cliente muda de assunto com confiança, o handoff acontece no mesmo turno.
O threshold de 0,75 eu escolhi na mão, não calibrei. E aqui apareceu um detalhe importante: o mesmo threshold não serve pra provedores diferentes. O MSD1 tende a ir pra 0,99 ou mais. O Jev espalha mais a probabilidade nos casos de fronteira (por exemplo financeiro=0.62, devolucao=0.38). Com τ = 0,75, o MSD1 pediu clarificação em 1 dos 76 turnos e o Jev em 5. O threshold é por provedor, e trocar de provedor em produção exigiria recalibrar num conjunto de validação.
Subagentes que conversam de verdade
Cada subagente é um create_react_agent com o seu prompt e as suas tools. Dois detalhes deram trabalho.
O primeiro: o subagente recebe o diálogo (falas do cliente e respostas finais), mas não recebe as tool calls dos colegas:
def _so_dialogo(msgs):
    return [m for m in msgs if isinstance(m, HumanMessage)
            or (isinstance(m, AIMessage) and m.content and not m.tool_calls)]
Sem esse filtro, um agente herdava no histórico chamadas a tools que ele nem tem, e isso gerava erro de tool desconhecida.
O segundo: a clarificação recebe os dois candidatos mais prováveis no prompt, pra perguntar algo específico em vez de um genérico “como posso ajudar?”. A instrução é explícita: não responder ao mérito, fazer uma pergunta só, sem menu. Na seção de falhas você vai ver que isso não bastou.
O que eu vi rodando
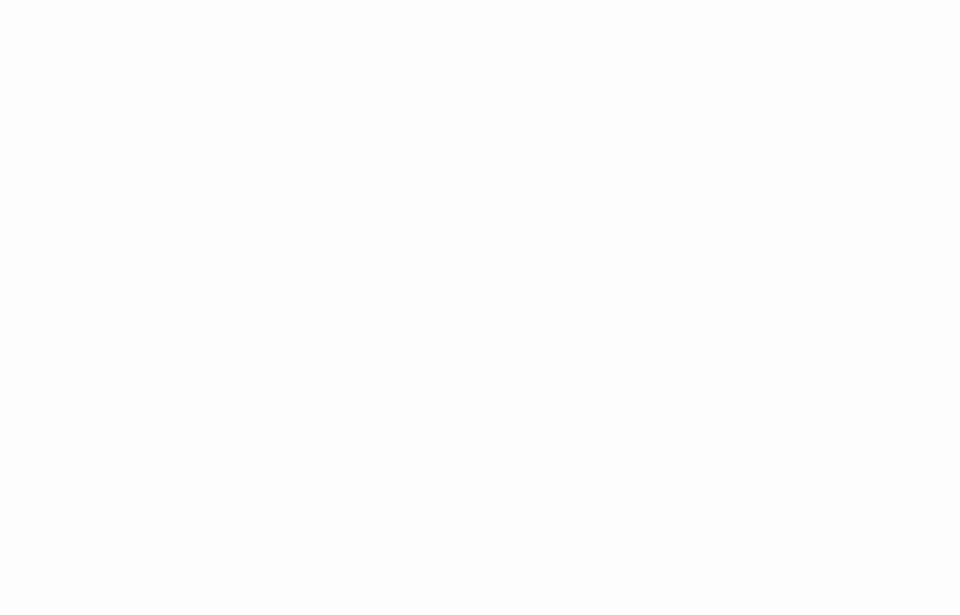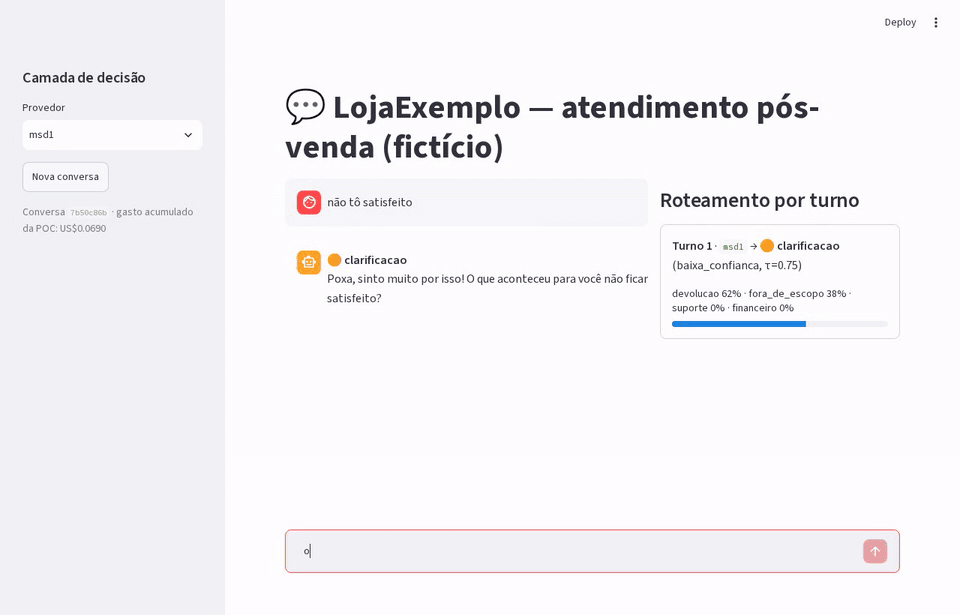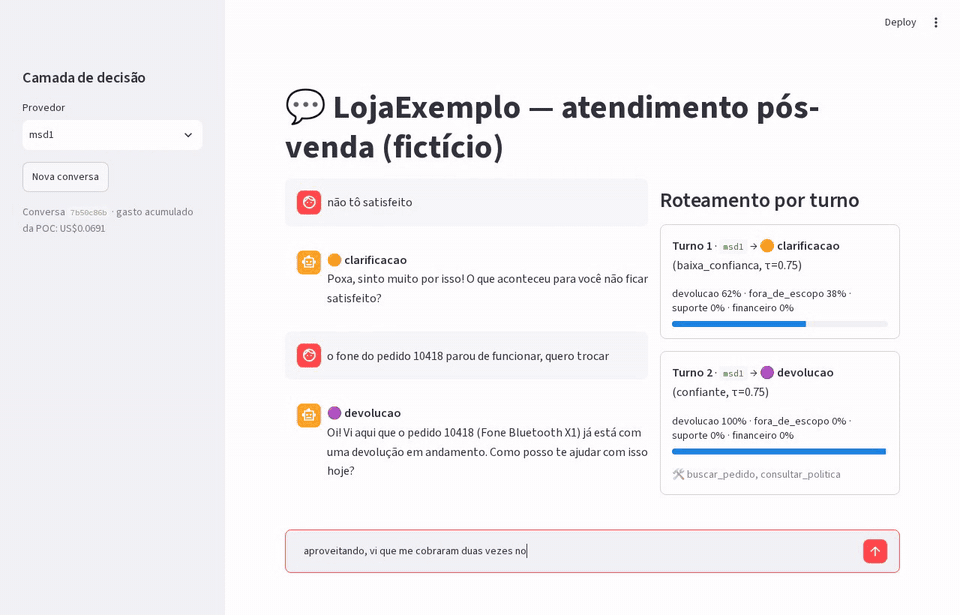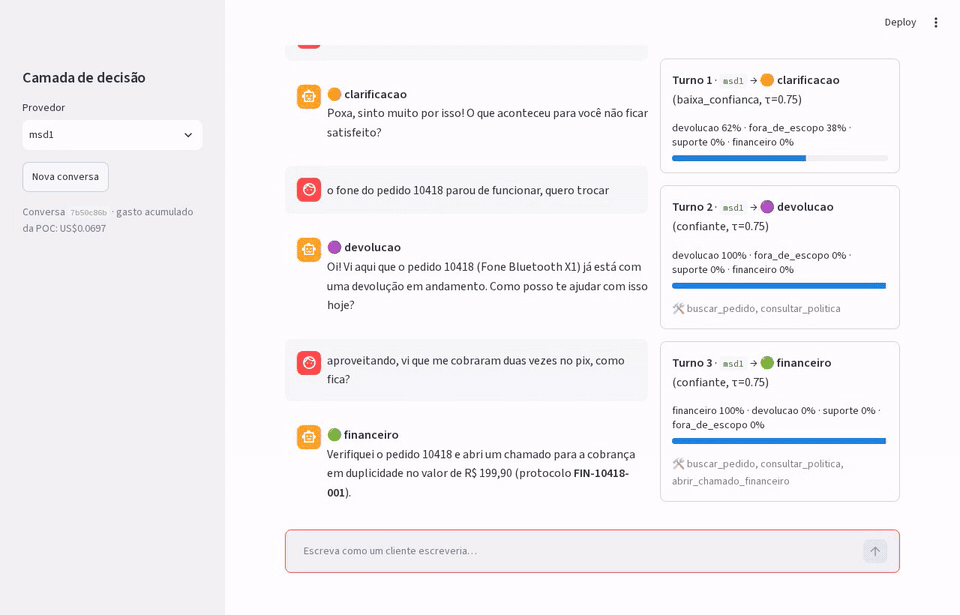
Gravação real da interface (Streamlit + OpenRouter, sem cortes). À direita, as probabilidades do MSD1 em cada turno.
Troca de assunto no meio da conversa, com o MSD1:
👤 oi, meu tênis do pedido 10405 ainda não chegou, cadê?
   ↳ [msd1] suporte=1.00 ... → suporte (confiante)
   ↳ ferramentas: buscar_pedido({"numero_pedido": "10405"})
👤 aproveitando, vi que me cobraram duas vezes esse pedido no pix
   ↳ [msd1] financeiro=1.00 ... → financeiro (confiante)
   ↳ ferramentas: buscar_pedido(...); consultar_politica(...); abrir_chamado_financeiro({"valor": 349, "tipo": "estorno_duplicidade", ...})
👤 beleza, e em quanto tempo volta o dinheiro?
   ↳ [msd1] financeiro=1.00 ... → financeiro (confiante)
E a clarificação funcionando como deveria:
👤 não tô satisfeito
   ↳ [msd1] devolucao=0.68 fora_de_escopo=0.32 ... | conf=0.68 τ=0.75 → clarificacao (baixa_confianca)
🤖 [clarificacao] Entendo. Para eu te ajudar da melhor forma, você gostaria de falar sobre a devolução de algum produto ou é sobre outro assunto?
👤 o fone do pedido 10418 parou de funcionar, quero trocar
   ↳ [msd1] devolucao=1.00 ... → devolucao (confiante)
Também teve um “aliás, você sabe se vai chover amanhã em SP?” no meio de um atendimento de endereço. Foi pra fora de escopo, e no turno seguinte (“ok rs. então o endereço já ficou certo né?”) voltou pro suporte, que confirmou o endereço atualizado dois turnos antes.
Os números, com o tamanho certo
Montei 76 turnos fictícios: aberturas, follow-ups curtos que dependem do histórico, trocas de assunto, linguagem informal e 8 casos que eu marquei como ambíguos (nesses, clarificar conta como acerto). τ = 0,75.
| Provedor | Acurácia top-1 | Não ambíguos | Clarificação | Latência mediana | Custo (76 turnos) |
|---|---|---|---|---|---|
| MSD1 | 98,7% (75/76) | 100% | 1,3% (1) | 232 ms | US$0,0007 |
| Jev | 96,1% (73/76) | 100% | 6,6% (5) | 195 ms | US$0,0017 |
| Classificador LLM (Gemini 3.5 Flash Lite) | 98,7% (75/76) | 100% | 9,2% (7) | 897 ms | US$0,022 |
Antes de tirar qualquer conclusão, o tamanho da amostra: 76 turnos é pouco. Os três acertaram todos os 68 casos não ambíguos, e todas as diferenças estão nos 8 ambíguos, cujo rótulo é discutível (fui eu que decidi o que era ambíguo). A diferença entre 98,7% e 96,1% são dois turnos. Com um conjunto desse tamanho, isso não é evidência de que o MSD1 roteia melhor que o Jev.
O único erro de top-1 do MSD1 foi justamente um ambíguo: “quero cancelar e receber o dinheiro” foi pra suporte com 0,91, e eu tinha rotulado financeiro. Dá pra defender as duas leituras.
O que a tabela mostra com mais segurança é a diferença de ordem de grandeza em custo e latência:
- o classificador LLM custou mais de 30× o MSD1 e levou quase 4× mais tempo na mediana;
- o Jev foi o mais rápido, mas saiu cerca de 2,5× mais caro que o MSD1. O preço de tabela é o mesmo (US$0,042 por milhão de tokens de entrada, saída grátis), mas o Jev contabiliza bem mais tokens de entrada pro mesmo pedido. Nos traces da demo, as chamadas do Jev ficaram entre 520 e 857 tokens de entrada, e as do MSD1 entre 201 e 364.
E tem uma diferença de natureza, não de número: a “confiança” do classificador LLM é uma nota que ele mesmo escreve. Ele foi o que mais pediu clarificação (7 vezes), e isso não quer dizer que ele estava mais inseguro. Quer dizer que ele escreveu números mais baixos.
Pra mim, a avaliação mostra que a arquitetura funciona com qualquer um dos três. Ela não mostra qual é o melhor roteador.
Onde quebrou
As falhas que importam não estavam no roteador.
A clarificação desobedece. Mesmo com “NÃO responda ao mérito” no prompt, o Flash Lite às vezes respondeu em vez de perguntar. Num caso com o Jev, o cliente disse “valeu! e o reembolso cai como? paguei no cartão”. A confiança ficou em 0,62 (financeiro contra devolução) e o turno foi pra clarificação, que respondeu direto: “Como você pagou no cartão, o reembolso será solicitado à administradora…”. Sem tools, ele respondeu sem consultar a política. A rota estava certa. O agente é que não seguiu o papel dele.
O que eu faria na próxima versão: tirar o LLM da clarificação e montar a pergunta a partir dos dois candidatos mais prováveis, ou passar pra ele só a última mensagem.
O financeiro abriu chamado sem confirmação nos dados. Na base fictícia, o pedido 10418 tem uma cobrança registrada. Mesmo assim, quando o cliente disse que foi “cobrado de novo no pix”, o financeiro chamou buscar_pedido, viu o pedido e abriu abrir_chamado_financeiro com tipo: estorno_duplicidade. Isso aconteceu na gravação da interface (deixei o GIF sem cortes justamente pra mostrar) e se repetiu nas demos com MSD1, Jev e A/B. Não foi um acaso: é o comportamento do agente. Já no pedido 10405, que de fato tem duas cobranças, o chamado estava correto.
A correção certa não é mais uma linha no prompt. É a tool recusar o chamado quando o dado não confirma a duplicidade. Regra de negócio que importa vai pro código, não pro prompt.
Detalhes menores. O Flash Lite chegou a chamar atualizar_endereco com um endereço provisório antes de o cliente informar o novo (corrigi com uma regra na docstring da tool). Num turno, ele repetiu que o pagamento tinha sido via Pix depois de o cliente dizer “cartão”. O dado do sistema estava certo, mas o agente não tratou a divergência com o que o cliente disse.
Quanto custou e como eu travei o gasto
| US$ | |
|---|---|
| Total no ledger local (479 chamadas, incluindo a gravação do GIF) | 0,0709 |
| Gemini 3.5 Flash Lite (subagentes + classificador LLM) | 0,0667 |
| Jev | 0,0029 |
| MSD1 | 0,0013 |
Quase todo o gasto foi do LLM gerativo. O roteamento com modelo de decisão custou pouco mais de um décimo de centavo.
O teto da POC era US$3, com parada em US$2,80. O ledger reserva o custo máximo estimado antes de cada chamada e registra o usage.cost real depois. Se a reserva estoura o limite, a chamada nem sai. E esse erro de orçamento é o único que o fallback não engole: se o dinheiro acabou, cair pro próximo provedor só gastaria mais. No fim, o ledger bateu com a diferença do saldo da conta no OpenRouter antes e depois.
Limitações
- Os dados são 100% fictícios. Os 76 turnos e os rótulos foram escritos com apoio de LLM e não passaram por revisão humana. Os casos ambíguos refletem o meu julgamento.
- A amostra é pequena e não tem poder estatístico pra comparar provedores.
- As tools são simuladas. Não tem autenticação de cliente nem efeito real.
- A memória (
MemorySaver) fica em processo. Em produção, eu trocaria por um checkpointer persistente, como Postgres ou Redis. - O endpoint de decisões está em alpha. O contrato pode mudar, e é por isso que o fallback pra um classificador LLM existe.
- Não tem handoff dentro do subagente. O financeiro não devolve a conversa pra devolução. Toda troca passa pelo classificador no turno seguinte.
Como rodar
python -m venv .venv && . .venv/bin/activate && pip install -r requirements.txt
export OPENROUTER_API_KEY=...            # nunca vai pro repositório
pytest -q                                 # 13 testes, offline
python scripts/demo.py --provedor msd1    # também: jev | llm | ab | msd1+fallback --simular-queda-msd1
python scripts/avaliar.py                 # avaliação de roteamento msd1 × jev × llm
python scripts/chat.py --provedor jev     # chat no terminal
streamlit run app.py                      # interface web
O repo tem os traces completos de cada turno (probabilidades, tools, custo e latência), as saídas de terminal e o resumo da avaliação em evidencias/.
O próximo passo
A lição que eu levo: com um modelo de decisão, o roteador vira a parte barata e previsível do sistema, e a parte difícil continua sendo o agente que age. Se eu fosse colocar isso em produção, o roteamento seria a menor das preocupações. O trabalho estaria em tirar decisões de negócio do prompt e colocar nas tools.
Se você já tem um bot multiagente com um LLM como roteador, um teste barato pra fazer hoje: pegue o log de algumas centenas de mensagens, rode o seu roteador e um modelo de decisão lado a lado e compare três coisas: concordância, latência e custo. E olhe com carinho onde a confiança fica abaixo de 0,75. É ali que o seu bot deveria estar perguntando, e não chutando.
O código está em github.com/gabrielcaiana/poc-langchain-roteamento-decisao.
Me segue no LinkedIn e no GitHub pra acompanhar os próximos experimentos.